> Facebook zaczyna być nudny, przereklamowany
If you are using Peekr right now and having issues when accessing the site, it’s due to a bug in math-based alternative captcha I’ve recently introduced to combat spambots. I am aware of this and trying to ship a fix as soon as possible, stay tuned!
UPDATE: I’ve identified the issue, I’ll be pushing a proper fix shortly
UPDATE 2: Issue has been fixed!
Przynajmniej dobrowolnie, bo jak w praniu jest, to raczej zebranej tutaj gawiedzi nie muszę dowodzić.
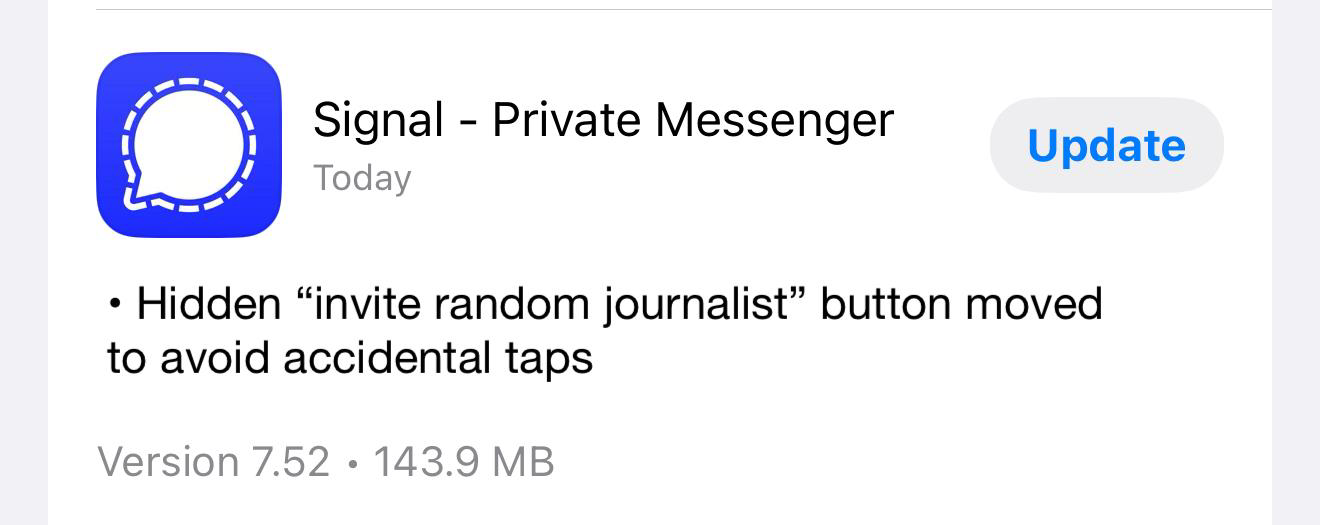
Wow, jak nie “tiktoker”, to teraz “aktor w filmie «Kamienie na szaniec»”. Świetny ten PLLuM. Nazwa zobowiązuje – pieniądze publiczne rzeczywiście tak zrobiły.
Dosłownie nie rozumiem, o co tyle hałasu, że musicie gonić po czerwony pasek w każdym roku szkolnym. Jesteśmy w 2025 roku, jest o wiele więcej możliwości niż nawet te 10-15 lat temu.
Nie uda się dostać na Wasze “wymarzone studia”? Pójdźcie do szkoły policealnej, zacznijcie zarabiać kasę na kursy zawodowe. Nie chcą Cię drzwiami? Wejdź przez okno.
Zostałem zaproszony do napisania tekstu dla jednego z pism na temat sztucznej inteligencji. I po raz kolejny mogę z dumą zdementować, że matura się do czegokolwiek przydaje xD
Na maturze miałbym problem z napisaniem 200 słów na temat, który mnie guzik interesuje.
Z kolei artykuł, który obecnie piszę? Prawie 1,5 tysiąca słów. A nawet nie jestem w połowie. Mój dotychczasowy rekord to około 4 tysiące słów we wpisie na Kontrabandzie.
Szach mat, czerwonopaskowcy.
First and foremost, we should not expect from an alternative platform doing exact same things as their mainstream counterpart. I think that’s one of reasons why most people don’t bother with alternatives and thus the exodus is slated to fail.
There’s a reason why an alternative platform was enacted at all – and the reason is, of course, to potentially pursuit anything for better. And if an alternative platform is supposed to do same toxic things as their mainstream counterpart, we will continue to normalise what in a healthy society would be successfully boycotted a long time ago.
Tak jak pisałem:
> Konkludując, jeżeli podamy do wytrenowania źle zdefiniowane dane – to algorytm będzie produkował częściej paszkwile.
To też. Ale mimo wszystko algorytm obsługujący taki model się nie stanie samodzielny (wbrew temu co sugerują niektóre nagłówki w mainstreamowych mediach). Realizuje tylko to, co się mu zada.
Rozumiem kontekst postu, ale pozwolę sobie tutaj na trochę technikaliów: to działa tak, że modele sztucznej inteligencji są po prostu rozbudowanymi ciągami Markowa.
Ciąg Markowa to coś na wzór rachunku prawdopodobieństwa, z tym że stopień szansy można dowolnie dostosowywać. Coś, co ma większą wagę (szansę), to istnieje większa szansa na to, że algorytm wybierze właśnie daną rzecz. Każda odpowiedź będzie zależna wyłącznie od tego, jak (i na czym) stworzymy (“wytrenujemy”) taki ciąg. Nawet jeżeli dane będą świetnej jakości, to zawsze istnieje ryzyko opatrzenia poszczególnego zdjęcia błędnym opisem. Nigdy nie jest ono zerowe i z tego względu nigdy nie dojdzie do tego, że AI nas całkowicie zastąpi.
Co najwyżej można potraktować go jako szybką pomoc, a odpowiedzi generowane przez narzędzia o modele AI nie powinny być używane jako panaceum na wszystko. Algorytm napisany przez nas tylko wykonuje wskazane przez nas instrukcje.
Konkludując, jeżeli podamy do wytrenowania źle zdefiniowane dane – to algorytm będzie produkował częściej paszkwile.